Du fragst dich, ob lokale KI-Modelle die richtige Lösung für deine Datenverarbeitung und Analyse sind, insbesondere im Hinblick auf Vorteile, den benötigten Hardwareaufwand und wie du deine Daten schützen kannst. Entscheidungen bezüglich des Einsatzes von Künstlicher Intelligenz (KI) erfordern ein tiefes Verständnis der technischen und sicherheitsrelevanten Aspekte, um maximale Effizienz und Vertraulichkeit zu gewährleisten.
Warum lokale KI-Modelle für dich relevant sind
Die Entscheidung, KI-Modelle lokal auf deinen eigenen Servern oder Geräten zu betreiben, anstatt auf Cloud-basierte Lösungen zurückzugreifen, bringt signifikante Vorteile mit sich, insbesondere wenn es um die Verarbeitung sensibler oder unternehmensspezifischer Daten geht. Lokale KI ermöglicht dir eine stärkere Kontrolle über deine Daten und kann Latenzzeiten drastisch reduzieren. Dies ist entscheidend für Echtzeitanwendungen und Szenarien, in denen Datenschutz oberste Priorität hat.
Vorteile des Betriebs von KI-Modellen auf lokaler Infrastruktur
Der Betrieb von KI-Modellen auf deiner eigenen Hardware bietet dir eine Reihe überzeugender Vorteile:
- Datenschutz und Sicherheit: Der offensichtlichste Vorteil ist die vollständige Kontrolle über deine Daten. Da die Daten nicht an externe Server gesendet werden müssen, entfällt das Risiko von Datenlecks bei Cloud-Anbietern. Dies ist besonders wichtig für Unternehmen, die mit sensiblen Kundendaten, geistigem Eigentum oder personenbezogenen Informationen arbeiten. Du erfüllst Compliance-Anforderungen leichter, da du die Datenhoheit behältst.
- Reduzierte Latenzzeiten: Lokale Modelle greifen direkt auf deine Daten zu, ohne den Umweg über das Internet. Dies führt zu deutlich geringeren Antwortzeiten, was für Anwendungen, die Echtzeitverarbeitung erfordern, wie z.B. autonome Systeme, industrielle Automatisierung oder interaktive Benutzeroberflächen, unerlässlich ist.
- Kostenkontrolle und Vorhersehbarkeit: Während die anfänglichen Investitionen in Hardware hoch sein können, bieten lokale KI-Modelle langfristig eine potenziell bessere Kostenkontrolle. Du zahlst keine laufenden Nutzungsgebühren pro API-Aufruf oder Datenmenge, sondern hast deine Infrastrukturkosten im Griff. Dies macht die Budgetierung einfacher und vermeidet unerwartete Kostensteigerungen.
- Unabhängigkeit von externen Anbietern: Du bist nicht von der Verfügbarkeit oder den Servicebedingungen von Cloud-Providern abhängig. Ausfälle oder Änderungen in den Geschäftsmodellen externer Anbieter beeinträchtigen deine KI-Infrastruktur nicht. Diese Unabhängigkeit gibt dir strategische Freiheit und Planungssicherheit.
- Anpassbarkeit und Integration: Lokale Modelle lassen sich oft tiefer an deine spezifischen Bedürfnisse und bestehenden Systeme anpassen. Du kannst Modelle feinabstimmen, optimieren und nahtlos in deine bestehende IT-Landschaft integrieren, ohne auf die Schnittstellen und Einschränkungen von Cloud-Diensten angewiesen zu sein.
- Optimierte Leistung für spezielle Workloads: Für sehr spezifische oder rechenintensive Aufgaben kannst du deine lokale Hardware exakt auf die Anforderungen des KI-Modells abstimmen, um maximale Leistung und Effizienz zu erzielen, die in einer generischen Cloud-Umgebung möglicherweise teurer oder schwieriger zu erreichen ist.
Hardwarebedarf für lokale KI-Modelle
Der Betrieb von KI-Modellen auf lokaler Infrastruktur erfordert eine sorgfältige Planung und Investition in leistungsfähige Hardware. Die Anforderungen variieren stark je nach Modellgröße, Komplexität und der Art der durchzuführenden Aufgaben (Training, Inferenz oder beides). Hier sind die Schlüsselelemente:
Rechenleistung: CPUs und GPUs
Das Herzstück jeder KI-Verarbeitung ist die Recheneinheit. Für lokale KI-Modelle spielen sowohl Central Processing Units (CPUs) als auch Graphics Processing Units (GPUs) eine entscheidende Rolle:
- CPUs: Moderne CPUs mit vielen Kernen und hoher Taktfrequenz sind für vorbereitende Datenaufgaben, Modellmanagement und die Ausführung von KI-Modellen, die nicht stark auf parallele Berechnungen angewiesen sind, unerlässlich. Sie sind jedoch für das Training tiefer neuronaler Netze oft zu langsam.
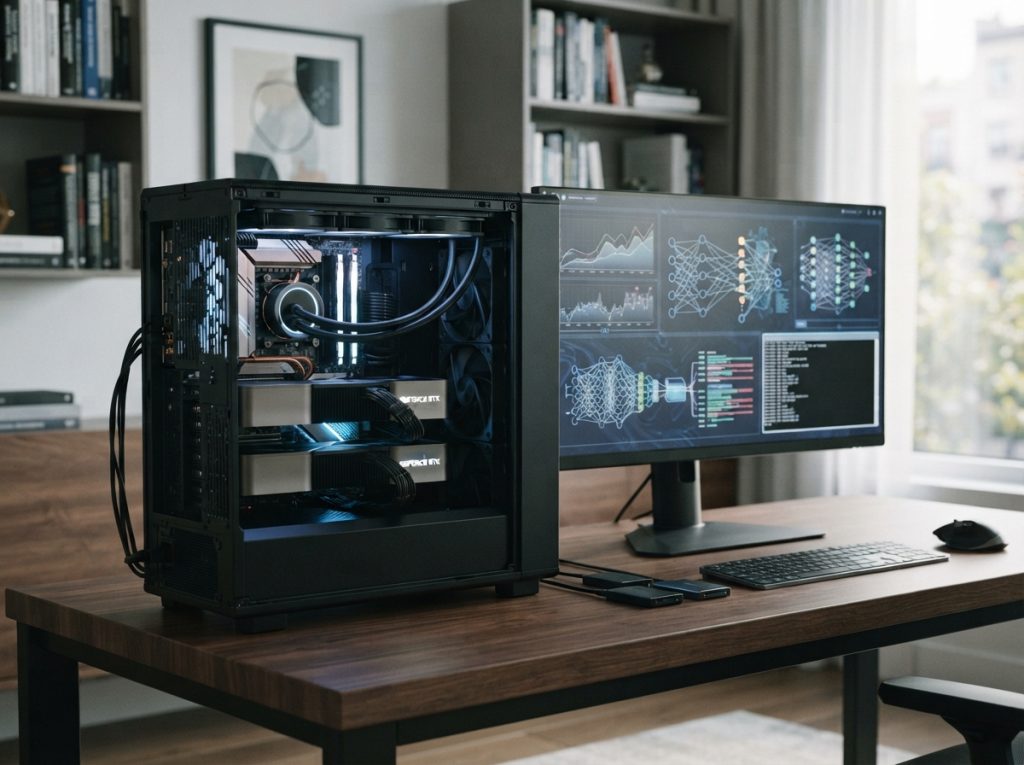
- GPUs: GPUs sind aufgrund ihrer Architektur, die für massive parallele Berechnungen ausgelegt ist, unverzichtbar für das Training und die Inferenz von Deep-Learning-Modellen. Je größer und komplexer das Modell, desto mehr GPU-Leistung wird benötigt. Für anspruchsvolle Aufgaben sind professionelle Workstation- oder Server-GPUs (z.B. NVIDIA Tesla/RTX Serie, AMD Instinct) mit viel VRAM (Video Random Access Memory) und hoher Rechenleistung (gemessen in TFLOPS) empfehlenswert. Der VRAM ist entscheidend, um große Modelle und Datensätze im Speicher zu halten.
- TPUs (Tensor Processing Units) und spezialisierte KI-Beschleuniger: Neben GPUs gibt es auch spezialisierte KI-Beschleuniger wie Googles TPUs oder andere ASICs (Application-Specific Integrated Circuits), die für bestimmte KI-Workloads noch effizienter sein können. Diese sind oft teurer und weniger flexibel als GPUs, können aber bei dedizierten Anwendungsfällen erhebliche Leistungsvorteile bieten.
Speicher und Datenspeicherung
Der Zugriff auf und die Speicherung von Daten sind ebenso kritisch:
- RAM (Random Access Memory): Ausreichend Arbeitsspeicher ist notwendig, um Modelle und Datensätze während der Verarbeitung im Speicher zu halten. Für große Modelle können 64 GB, 128 GB oder sogar mehr RAM erforderlich sein.
- SSD-Speicher: Schnelle Solid State Drives (SSDs), insbesondere NVMe-SSDs, beschleunigen das Laden von Daten und Modellen erheblich. Dies reduziert Wartezeiten beim Start von Trainingsläufen oder Inferenzprozessen.
- Massenspeicher: Für die Speicherung großer Datensätze, die für das Training benötigt werden, sind leistungsfähige Speicherlösungen wie Network Attached Storage (NAS) oder Storage Area Networks (SAN) erforderlich. Die Geschwindigkeit und Kapazität dieser Systeme müssen auf die Datenmenge und die Zugriffsanforderungen abgestimmt sein.
Netzwerk und Kühlung
Auch diese Aspekte sind nicht zu unterschätzen:
- Netzwerkinfrastruktur: Eine schnelle und zuverlässige Netzwerkanbindung ist wichtig, insbesondere wenn du verteilte Trainingsszenarien durchführst oder Daten von verschiedenen Quellen sammelst.
- Kühlsysteme: Hochleistungs-CPUs und GPUs erzeugen viel Wärme. Eine adäquate Kühlung ist unerlässlich, um Überhitzung zu vermeiden und die Lebensdauer der Hardware zu verlängern. Dies kann von leistungsstarken Lüftern bis hin zu komplexen Flüssigkühlsystemen reichen.
- Stromversorgung: KI-Workloads sind extrem stromhungrig. Stelle sicher, dass deine Stromversorgung stabil und ausreichend dimensioniert ist, um Spitzenlasten abzudecken. Unterbrechungsfreie Stromversorgungen (USVs) sind ratsam.
Datenschutz und Sicherheit bei lokalen KI-Modellen
Obwohl der Betrieb von KI-Modellen lokal den Datenschutz verbessert, ist er keine Garantie für absolute Sicherheit. Du trägst die volle Verantwortung für den Schutz deiner Daten und Modelle. Hier sind zentrale Aspekte, die du beachten musst:
Zugriffskontrolle und Authentifizierung
Implementiere strenge Richtlinien für den Zugriff auf deine KI-Infrastruktur:
- Rollenbasierte Zugriffskontrolle (RBAC): Definiere klare Rollen und Berechtigungen für Benutzer und Anwendungen, die auf die KI-Systeme zugreifen. Nur autorisierte Personen sollten Zugriff auf sensible Daten und Modelle haben.
- Starke Authentifizierung: Nutze Multi-Faktor-Authentifizierung (MFA) für alle Zugriffe. Passwörter allein reichen oft nicht aus.
- Regelmäßige Überprüfung der Zugriffsrechte: Überprüfe und aktualisiere regelmäßig, wer Zugriff auf welche Ressourcen hat, insbesondere wenn Mitarbeiter das Unternehmen verlassen oder ihre Rollen wechseln.
Verschlüsselung
Schütze deine Daten durch Verschlüsselung, sowohl im Ruhezustand als auch während der Übertragung:
- Datenverschlüsselung im Ruhezustand: Verschlüssele Daten auf Speichermedien, Datenbanken und Backups. Dies schützt deine Daten, falls physischer Zugriff auf die Hardware erlangt wird.
- Datenverschlüsselung während der Übertragung: Verwende sichere Protokolle wie TLS/SSL für die Übertragung von Daten innerhalb deines Netzwerks und zu/von externen Quellen, falls dies unumgänglich ist.
- Modellverschlüsselung: Auch deine trainierten Modelle können sensitives Wissen enthalten. Erwäge die Verschlüsselung deiner Modelle, um unbefugten Zugriff und Reverse Engineering zu verhindern.
Physische Sicherheit
Schütze deine Server vor physischem Zugriff:
- Sicherer Standort: Betreibe deine KI-Hardware in einem gesicherten Rechenzentrum oder Serverraum mit kontrolliertem Zugang.
- Überwachung: Implementiere Videoüberwachung und Zugangsprotokolle für den physischen Zugang zum Serverraum.
- Schutz vor Umweltgefahren: Stelle sicher, dass der Standort vor Feuer, Wasser und anderen Umweltrisiken geschützt ist.
Software-Sicherheit und Wartung
Regelmäßige Wartung und Sicherheitsupdates sind unerlässlich:
- Patch-Management: Halte Betriebssysteme, Treiber und alle verwendeten Software-Bibliotheken (einschließlich KI-Frameworks) stets auf dem neuesten Stand, um bekannte Sicherheitslücken zu schließen.
- Firewalls und Intrusion Detection/Prevention Systeme (IDS/IPS): Richte robuste Firewalls ein und nutze IDS/IPS, um unerwünschten Netzwerkverkehr zu erkennen und zu blockieren.
- Sichere Konfiguration: Konfiguriere alle Systeme nach dem Prinzip der geringsten Rechte und deaktiviere unnötige Dienste.
- Regelmäßige Backups: Erstelle regelmäßige, getestete Backups deiner Daten und Modelle. Bewahre Backups sicher auf und teste regelmäßig die Wiederherstellung.
- Sicherheitsaudits: Führe regelmäßige Sicherheitsaudits und Penetrationstests durch, um Schwachstellen in deiner Infrastruktur aufzudecken.
Modell-Sicherheit
Schütze deine trainierten KI-Modelle selbst:
- Schutz vor Poisoning Attacks: Sei vorsichtig bei der Aufnahme von Daten aus unbekannten Quellen, da diese dazu missbraucht werden könnten, dein Modell zu manipulieren.
- Schutz vor Model Extraction Attacks: Verhindere, dass Angreifer durch wiederholte Abfragen Rückschlüsse auf die Funktionsweise deines Modells ziehen oder es sogar replizieren können. Implementiere Ratenbegrenzungen und Analysen des Abfrageverhaltens.
Übersicht über Lokale KI-Modelle
| Kategorie | Beschreibung und Relevanz für dich |
|---|---|
| Vorteile | Maximale Datenkontrolle, geringe Latenz, Kostenkontrolle, Unabhängigkeit, tiefe Anpassbarkeit. Bietet dir Souveränität über deine KI-Implementierung und schützt sensible Daten effektiv. |
| Hardwarebedarf (Inferenz) | Optimierte CPUs, dedizierte Beschleuniger (GPUs, NPUs) mit ausreichend VRAM, schnelle SSDs. Essentiell für schnelle und kosteneffiziente Ausführung trainierter Modelle in Echtzeit. |
| Hardwarebedarf (Training) | Mehrere leistungsstarke GPUs mit viel VRAM, hohe RAM-Kapazität, schnelle Massenspeicherlösungen. Erforderlich für die Entwicklung und das Trainieren komplexer KI-Modelle von Grund auf. |
| Datenschutzmaßnahmen | Zugriffskontrolle, starke Authentifizierung, Verschlüsselung (Daten und Modelle), physische Sicherheit, sichere Softwarekonfiguration und regelmäßige Updates. Deine Verantwortung für den Schutz deiner sensiblen Informationen. |
| Betriebsmodelle | On-Premise-Server, private Cloud-Infrastruktur. Ermöglicht dir die vollständige Kontrolle über deine Hardware- und Software-Umgebung. |
FAQ – Häufig gestellte Fragen zu Lokale KI-Modelle: Vorteile, Hardwarebedarf und Datenschutz
Muss ich immer High-End-Hardware für lokale KI-Modelle anschaffen?
Nicht unbedingt. Der genaue Hardwarebedarf hängt stark von deinen Anwendungsfällen ab. Wenn du KI-Modelle hauptsächlich für die Inferenz (also die Anwendung eines bereits trainierten Modells) auf kleineren Datensätzen oder mit weniger komplexen Modellen nutzt, können auch leistungsstarke Workstations oder sogar einzelne Server mit guten GPUs ausreichen. Für das Training großer, komplexer Modelle, wie sie in der fortgeschrittenen Forschung oder für hochperformante Produkte üblich sind, ist jedoch leistungsstarke und oft skalierbare Hardware, einschließlich mehrerer GPUs, notwendig.
Wie schütze ich meine lokal gespeicherten Trainingsdaten vor unerlaubtem Zugriff?
Du schützt deine Trainingsdaten durch eine Kombination aus technischen und organisatorischen Maßnahmen. Technisch bedeutet das: Implementiere eine strenge, rollenbasierte Zugriffskontrolle (RBAC) auf deine Speichersysteme. Nutze Verschlüsselung für Daten im Ruhezustand (z.B. Festplattenverschlüsselung) und während der Übertragung (z.B. mit TLS/SSL). Physische Sicherheit des Serverraums ist ebenfalls essenziell. Organisatorisch gehört dazu die Schulung deiner Mitarbeiter im Umgang mit sensiblen Daten und die klare Definition von Richtlinien.
Kann ich KI-Modelle auch auf meinem Laptop lokal laufen lassen?
Ja, das ist möglich, aber stark von der Komplexität des Modells und der Art der Aufgabe abhängig. Kleinere Sprachmodelle, einfache Bilderkennungsmodelle oder Modelle für spezifische, nicht sehr rechenintensive Aufgaben können oft auf modernen Laptops mit dedizierten Grafikkarten (GPUs) ausgeführt werden. Für das Training großer Modelle oder die Ausführung komplexer Echtzeitszenarien ist ein Laptop in der Regel nicht ausreichend. Viele Entwickler nutzen Laptops für das Prototyping und die experimentelle Entwicklung.
Welche Kosten kommen bei der Implementierung lokaler KI-Modelle auf mich zu?
Die Kosten für lokale KI-Modelle setzen sich primär aus Anfangsinvestitionen in Hardware (Server, GPUs, Speicher), laufenden Betriebskosten (Strom, Kühlung, Wartung, Personal) und potenziellen Softwarelizenzen zusammen. Im Gegensatz zu Cloud-Diensten, bei denen du pro Nutzung zahlst, sind lokale Kosten oft fixierter, aber die Anfangsinvestition ist höher. Eine sorgfältige TCO (Total Cost of Ownership)-Analyse ist ratsam, um die langfristige Wirtschaftlichkeit zu beurteilen.
Wie stelle ich sicher, dass meine lokalen KI-Modelle auch in Zukunft sicher bleiben?
Kontinuierliche Sicherheit ist ein fortlaufender Prozess. Das bedeutet, dass du regelmäßige Software-Updates und Patch-Management für dein Betriebssystem, deine KI-Frameworks und alle weiteren installierten Komponenten durchführen musst. Führe regelmäßige Sicherheitsaudits und Penetrationstests durch, um Schwachstellen proaktiv zu identifizieren. Überwache deine Systeme auf ungewöhnliche Aktivitäten (Intrusion Detection). Passe deine Sicherheitsrichtlinien und -maßnahmen an neue Bedrohungen und technologische Entwicklungen an.
Was passiert, wenn ein lokales KI-Modell auf meinen Daten trainiert wird und diese Daten sensibel sind?
Wenn deine lokalen KI-Modelle auf sensiblen Daten trainiert werden, verbleiben diese Daten innerhalb deiner kontrollierten Umgebung. Das bedeutet, du hast die volle Hoheit darüber, wer Zugriff auf die Trainingsdaten hat und wie sie verarbeitet werden. Dies minimiert das Risiko, dass sensible Informationen durch externe Dienstleister kompromittiert werden. Es ist deine Verantwortung, sicherzustellen, dass die entsprechenden Sicherheitsvorkehrungen (Verschlüsselung, Zugriffskontrollen etc.) implementiert sind, um die Vertraulichkeit und Integrität dieser Daten zu gewährleisten.
Wie kann ich meine trainierten KI-Modelle vor Diebstahl oder Missbrauch schützen?
Der Schutz deiner trainierten KI-Modelle ist essenziell, da sie wertvolles geistiges Eigentum darstellen können. Implementiere strenge Zugriffskontrollen auf die Speicherung der Modelle. Erwäge die Verschlüsselung deiner Modell-Dateien. Achte auf die physische Sicherheit der Server, auf denen die Modelle gespeichert sind. Überwache den Zugriff und die Nutzung der Modelle. Für kritische Anwendungen kann auch die Implementierung von Techniken zur Erkennung von Modell-Extraktion oder Adversarial Attacks (wenn Modelle von externen Nutzern abgefragt werden) sinnvoll sein.